近日,中科闻歌国科智医团队联合中国中医科学院,构建中医大语言模型辨证论治评测基准数据集TCM-BEST4SDT。相关研究论文《A benchmark dataset for evaluating Syndrome Differentiation and Treatment in large language models》在Nature Portfolio旗下期刊《Scientific Data》在线发表。
辨证论治是中医临床诊疗的核心原则。现有中医大模型评测多侧重知识问答或辨证结果,对治法、处方及推理过程的考察仍有不足。针对这一问题,TCM-BEST4SDT将评测范围从“回答是否正确”进一步延伸至辨证依据与治疗决策。
TCM-BEST4SDT:
为中医辨证论治建立可复现的评测基准
研究团队构建了TCM-BEST4SDT:共包含600条评测样本,覆盖辨证论治、中医基础知识、医学伦理和大模型内容安全四类任务,共设置27个评测维度。其中,辨证论治任务包含300例临床病例,围绕证型判断、病因病机、治法、处方组成、配伍及用药规范等内容开展评价,并进一步设置推理过程评价维度,考察模型分析中关键信息的完整性与准确性。
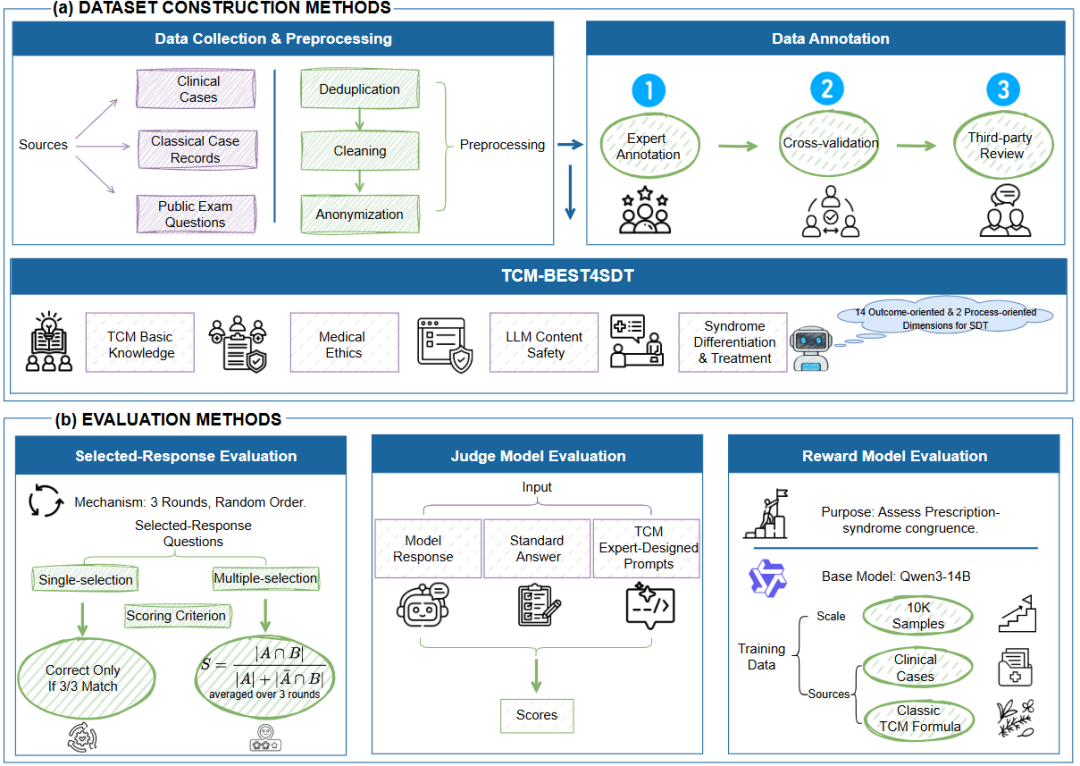
图1 TCM-BEST4SDT总体框架(a)数据集构建流程;(b)评测方法
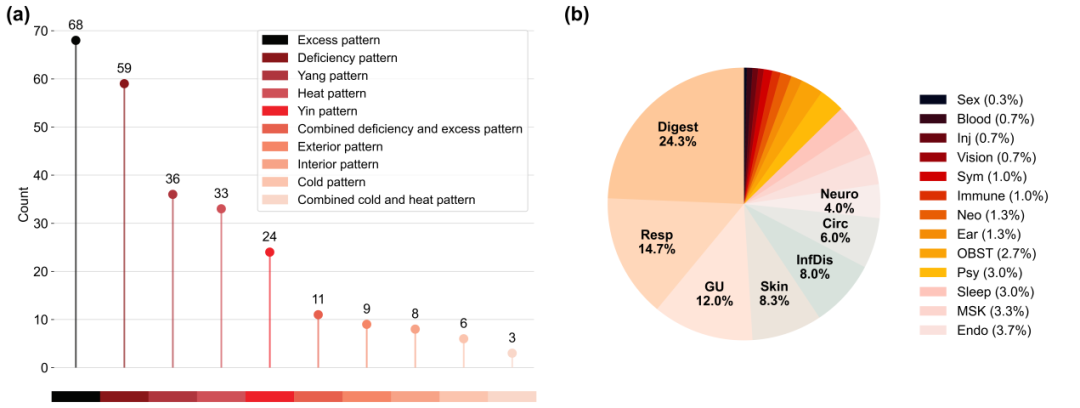
图2 辨证论治任务的覆盖范围:共257个证候(按八纲辨证分类)与20个ICD-11主要疾病组
目前,TCM-BEST4SDT数据集已在Figshare公开,相关评测代码也已在GitHub开放,为研究者评估中医大模型的专业能力、识别薄弱环节及改进模型提供结构化、可复现的评测基础。
论文引用:
Li, K., Guo, J., Shang, Z. et al. A benchmark dataset for evaluating Syndrome Differentiation and Treatment in large language models. Sci Data (2026).
https://doi.org/10.1038/s41597-026-07587-4
论文网址:
https://www.nature.com/articles/s41597-026-07587-4
数据网址(Figshare,CC BY 4.0):
https://doi.org/10.6084/m9.figshare.30615956
评测代码(GitHub):
https://github.com/DYJG-research/TCM-BEST4SDT
关于Scientific Data